LMCache MP 注册路径详解:register_kv_cache 到底在干什么
围绕 vLLM 调用 register_kv_caches 后传入的 KV cache、LMCache driven 多进程连接器的客户端处理、服务端注册、EngineGroupInfo 生成,以及普通 Attention、MLA、DeepSeek、Qwen 和 Mamba 等复杂模型布局,系统解释 LMCache 为什么需要这一层注册协议。
围绕 vLLM 调用 register_kv_caches 后传入的 KV cache、LMCache driven 多进程连接器的客户端处理、服务端注册、EngineGroupInfo 生成,以及普通 Attention、MLA、DeepSeek、Qwen 和 Mamba 等复杂模型布局,系统解释 LMCache 为什么需要这一层注册协议。
如果只看函数名,register_kv_cache 很像一个很普通的初始化步骤:vLLM 把 KV cache 告诉 LMCache,LMCache 记一下,后面就能用了。
但在 LMCache 的 multiprocess connector 里,这个注册动作其实是整条 GPU KV transfer 路径的“建模时刻”。
后续真正的 STORE / RETRIEVE 请求通常不会再携带完整 tensor 结构,也不会每次重新猜测每一层 KV cache 的 shape、dtype、stride、block 大小、group 关系。它们只会带 token 范围、cache key、block id、event handle 等轻量信息。服务端之所以能把这些轻量信息翻译成正确的 GPU copy,是因为 register_kv_cache 阶段已经把最重要的几件事都定下来了:
这篇文章只讲 LMCache driven 模式:vLLM worker 导出 KV cache 的 device handle,LMCache server 通过这些 handle 直接读写 worker 的 KV buffer。这里不展开 engine driven 模式。
本文基于 2026-09-16 复核的 LMCache PR #5042,head 为 e3cffcf,标题是 [Feature][MP] Support GLM-5.3-Flash and Qwen3.8-Flash-Next。PR 还在继续演进的话,请以当前代码为准。
动态图 1
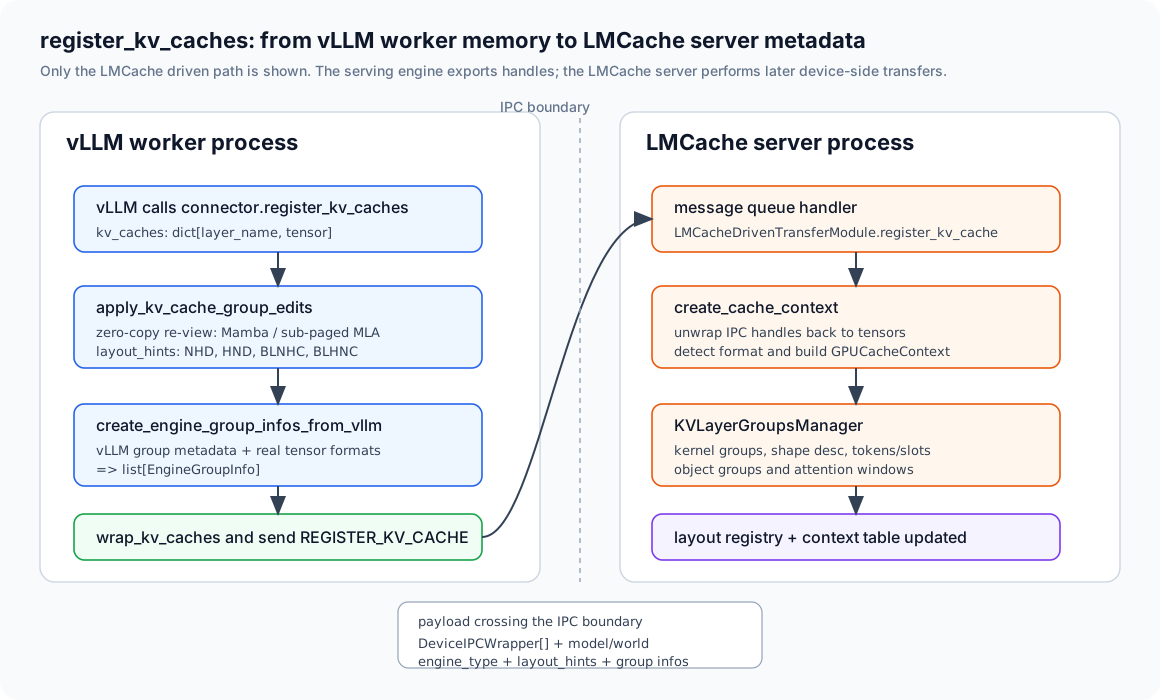
vLLM worker 先拿到真实的 KV tensor、KVCacheConfig 和 layout hints;后续所有轻量 STORE / RETRIEVE 都要依赖这次注册建立的契约。
大模型推理通常分成 Prefill 和 Decode。
Prefill 阶段一次读入 prompt,模型每一层 attention 会给每个 token 计算 Key 和 Value。Decode 阶段继续生成新 token,新 token 的 attention 需要读历史 Key / Value。如果每一步都把历史 prompt 重新算一遍,成本很高,所以推理引擎会把这些中间结果保存在显存里,这就是 KV cache。
vLLM 为了高效管理 KV cache,会把连续 token 切成 page,也常叫 block。请求的逻辑 token 序列通过 block table 映射到一组 block id。举一个非常普通的例子:
block_size = 16

tokens 0..15    -> block id 10
tokens 16..31   -> block id 11
tokens 32..47   -> block id 25
这里的 block id 不是 token id,而是 vLLM KV cache pool 里的页编号。attention kernel 通过 block table 找到每个 token 对应的 KV page。
LMCache 要做的是把这些已经算好的 KV cache 存到外部缓存层里,后续遇到相同 prefix 时再取回来写回 vLLM 的 KV buffer。于是问题来了:vLLM 的 KV buffer 是 vLLM 进程里的 GPU memory,LMCache server 是另一个进程。server 不可能凭空知道 worker 进程里的 tensor 在哪里,也不可能每次 STORE 时靠猜测来决定怎么搬。
所以注册阶段必须先建立一份跨进程契约:
这批 layer 的 KV tensor 在哪里?
它们长什么样?
vLLM 后续发来的 block id 应该对应哪些 tensor page?
LMCache 存储对象里的 chunk 又该怎么映射回这些 page?
这就是 register_kv_cache 这条路径的核心价值。
vLLM worker 侧调用的是 LMCache connector 的 register_kv_caches。在 PR 当前代码里,入口在 lmcache/integration/vllm/lmcache_mp_connector.py:
def register_kv_caches(self, kv_caches: dict[str, torch.Tensor]):
    kv_cache_config = getattr(self, "_kv_cache_config", None)
    layout_hints = vllm_layout_hints(self._vllm_config)
    kv_caches = apply_kv_cache_group_edits(
        kv_cache_config, kv_caches, layout_hints=layout_hints
    )
    engine_group_infos = create_engine_group_infos_from_vllm(
        kv_cache_config,
        kv_caches,
        layout_hints=layout_hints,
        dcp_size=self._dcp_size,
    )
    self.worker_adapter.register_kv_caches(
        kv_caches,
        engine_group_infos=engine_group_infos,
        layout_hints=layout_hints,
    )
这里传进来的主角是 kv_caches:
dict[str, torch.Tensor]key 是 layer name,比如 model.layers.0.self_attn.kv_cache 这一类名字;value 是对应 layer 的 KV cache tensor。对于一些 Mamba / linear attention 层,value 也可能先表现成 [conv_state, ssm_state] 这样的 tensor list,后面会被注册前的 edit 重新 view 成一个 LMCache 能处理的 page tensor。
除了真实 tensor,LMCache 还会读取 vLLM 的 KVCacheConfig。它里面最关键的是 kv_cache_groups。这里的 group 不是 LMCache 自己随便分的,而是 vLLM 调度侧定义的 KV cache group:
KVCacheGroupSpec(
  layer_names=[...],
  kv_cache_spec=...
)
kv_cache_spec 里有 block_size、attention 类型、sliding window 大小、Mamba cache mode、MLA 的 state 数、是否 prefix_cacheable 等信息。换句话说:
kv_caches 说明“真实内存长什么样”;kv_cache_config.kv_cache_groups 说明“vLLM 的调度和 block id 怎么理解这批内存”;layout_hints 说明 vLLM 选择了什么 KV layout,比如 NHD、HND、BLNHC、BLHNC。register_kv_caches 做的第一件事,就是把这三份信息合在一起。
LMCache driven 模式可以这样理解:
vLLM worker:
  我拥有 KV cache GPU memory。
  我把这批 tensor 包成 IPC handle 发给 server。

LMCache server:
  我 import 这些 handle,得到能指向 worker KV buffer 的 tensor view。
  后续 STORE 时我从 worker KV buffer 拷到 LMCache temp buffer / storage。
  后续 RETRIEVE 时我从 LMCache temp buffer / storage 写回 worker KV buffer。
所以客户端注册阶段会创建 LMCacheDrivenTransferContext。这个 context 先检查 KV cache 所在 device 是否支持 event IPC,然后调用 request client:
future = req_client.register_kv_cache(
    instance_id,
    wrap_kv_caches(kv_caches),
    model_name,
    world_size,
    engine_type,
    layout_hints,
    list(engine_group_infos),
)
future.result(timeout=mq_timeout)
注意这里发送的不是普通 tensor 本体。跨进程不能直接把 Python tensor 对象发过去。wrap_kv_caches(kv_caches) 会把 tensor 包成 DeviceIPCWrapper。可以把它理解成“这块 device memory 的可导入句柄 + shape/stride/storage offset 等重建信息”。
注册请求的 payload 里大致有这些东西:
| 字段 | 含义 |
|---|---|
instance_id |
当前 worker 实例,一般可以理解成一个 GPU worker 的注册身份 |
kv_cache |
DeviceIPCWrapper 列表,服务端用它 import worker 的 KV memory |
model_name |
cache key 和 layout registry 要按模型区分 |
world_size |
并行配置的一部分,同样影响 cache key 和 layout |
engine_type |
这里是 vLLM,用于服务端 format detection |
layout_hints |
vLLM 告诉 LMCache 的 layout 线索 |
engine_group_infos |
LMCache 从 vLLM group + tensor layout 生成的中立分组协议 |
这就是为什么注册不是“通知一下”而已。它实际上把 vLLM worker 的 GPU memory 接入了 LMCache server 的 transfer runtime。
apply_kv_cache_group_edits 是 PR #5042 里非常重要的背景点。它做的是 zero-copy re-view。
zero-copy 的意思是:不复制 KV bytes,只改变 tensor 的 shape / stride 视图,让 LMCache 后面的 format detection 和 transfer kernel 能用同一套规则理解它。
为什么需要 re-view?因为 vLLM 调度侧的 block id 粒度,和 worker attention kernel 实际使用的物理 page 粒度,有时不是一回事。
最普通的 attention 是这样的:
vLLM scheduler block id 7
        |
        v
worker tensor page 7

shape: [num_blocks, 2, block_size, num_heads, head_size]
一个 vLLM block 对应一个 tensor page。这时 LMCache 直接看 tensor shape,就能知道一个 page 里有多少 token slot。
但 hybrid / MLA / Mamba 模型会打破这个直觉。
这里最容易混的是 block_size 和 page_size。在 vLLM 的 KV cache spec 里,block_size 说的是“一个 block 管多少 token / state”;page_size_bytes 说的是“这样一个 page 实际占多少 bytes”。所以 page size 不是 token 数,而是内存大小。
对普通 attention 来说,一个 token 的 cache 大致包含 K 和 V 两份向量:
one-token attention bytes
  = K/V planes * num_kv_heads * head_size * dtype_size
因此 attention 的 page size 会随 block size 线性增长:
32-token attention page  -> 32 * one-token bytes
544-token attention page -> 544 * one-token bytes
但 Mamba / recurrent layer 不一样。它缓存的不是“每个 token 一行 K/V”,而是一组递归状态快照,比如 conv state、SSM state,再加上可能的 padding。Mamba 这一页有多大,主要由这些 state tensor 的 shape 和 dtype 决定,不是简单把 attention 的 token 行数乘起来。
Mamba-hybrid 模型同时有 attention group 和 Mamba group。vLLM 的 hybrid memory allocator 要把这些 group 放进同一套 KV cache 分组、容量估算和 block table 体系里,所以希望不同 group 的 page_size_bytes 对齐。这里的“对齐”是 bytes 级别的 page size 对齐,不是要求每个 group 都覆盖相同 token 数。
直观地说,allocator 和 scheduler 后面会不断问这类问题:每个 group 还能分配多少 page、一个 request 的第 N 个 block id 在各个 group 里对应哪一页、给定显存预算下还能承载多少并发。如果不同 group 的“一个 page”代表完全不同的 byte 量,统一估算和统一 block-id 账本就会变得很难维护,甚至容易把某个 group 的 page 数算错。
为什么会把 attention 的逻辑 block size 放大?因为 attention page bytes 可以通过增大 block size 来变大,而 Mamba state page bytes 往往已经由 state shape 决定了。假设 attention kernel 天然使用 32-token page,大小是 X;Mamba state page 大约是 17X。为了让两个 group 的 page size 对齐,vLLM 可以把 attention 的 manager block size 从 32 放大到 544:
natural attention kernel page: 32 tokens  -> X bytes
Mamba state page:              1 state    -> 17X bytes
aligned attention logical page:544 tokens -> 17X bytes
这里就出现了两个层次:
| 概念 | 站在哪一层看 | 含义 |
|---|---|---|
| logical block / manager block | scheduler、block table、prefix cache、LMCache register payload | vLLM 调度和 cache manager 认的 block id 单位。上面的例子里,一个 logical block 覆盖 544 个 token slot。 |
| physical block / kernel page | attention backend kernel、真实 worker tensor | kernel 真正读写的 tensor page 单位。上面的例子里,kernel 仍按 32-token page 访问。 |
所以“544-token logical block”不是说 FlashAttention kernel 忽然改成一次处理 544-token page。更准确地说,是 vLLM 的调度层把 17 个连续的 32-token kernel pages 视为同一个 manager block:
logical block 0
  = physical/kernel pages 0..16
  = 17 * 32 token slots
  = 544 token slots
这里有一个非常重要的配置约束:如果这个 cacheable group 的 tokens_per_block 真的是 544,那么 LMCache 的 chunk_size 不能继续用默认 256。当前 MP 路径要求 LMCache chunk size 必须是每个可缓存 group 的 tokens_per_block 的整数倍,因为一个 LMCache chunk 不能切在某个 vLLM logical block 的中间。也就是说:
tokens_per_block = 544
chunk_size = 256   -> 不行,注册阶段应直接报错
chunk_size = 544   -> 对这个 group 可以,一个 LMCache chunk 放 1 个 logical block
chunk_size = 1088  -> 对这个 group 可以,一个 LMCache chunk 放 2 个 logical blocks
如果同一个模型还有其它可缓存 group,比如另一个 group 的 tokens_per_block 是 64,那么 chunk_size 还要同时是 64 和 544 的共同倍数。实际配置通常要取所有 cacheable groups 的正 tokens_per_block 的共同倍数;prefix_cacheable = False 的临时 group 因为 tokens_per_block = 0,不参与这个约束。
所以 544 这个例子不是说“默认 256 也能保存 544-token block”,而是说明 hybrid/page-size 对齐可能会把 cache 的最小可注册粒度放大。真实部署时要么把 LMCache chunk_size 配成所有可缓存 group tokens_per_block 的共同倍数,要么这个模型就不能按当前这套 MP prefix KV 路径正确注册。
这也回答另一个常见疑问:是不是 544 个 token 以下就无法在 LMCache 里保存?在这类配置下,按完整 prefix chunk 来说,是的,低于一个 LMCache chunk 的前缀不会形成一个可复用的完整缓存对象。但这不代表当前请求自己不能 decode,也不代表 vLLM 显存里没有这些 KV;它只是不能作为 LMCache 跨请求复用的一个完整 chunk 被安全存取。LMCache 的可复用粒度由 chunk_size 决定,而 chunk_size 又必须和 engine group 的 logical block 边界对齐。
动态图 2
最开始 worker tensor 第一维数的是 kernel page,每个 page 只有 32 个 token slot;vLLM block id 还不能直接拿它当 544-token block 用。
[N * 17, 2, 32, H, C]
view, no copy
[N, 2, 544, 1, C']
这也是为什么 LMCache 注册时不能只看 raw tensor 的第一维。raw tensor 第一维可能是 kernel page 数,但 vLLM 传下来的 block id 属于 logical block 坐标系。LMCache 必须先把多个 physical pages 重新 view 成一个 logical page,否则后续 STORE / RETRIEVE 会用错 block id 到 byte range 的映射。
有了上面的概念,Sub-paged attention 就比较好理解了:它说的是 vLLM 调度侧的一个 logical attention block,被 attention backend 拆成了多个更小的 physical/kernel pages 存放。
于是 worker tensor 可能长这样:
[num_kernel_pages, 2, 32, num_heads, head_size]这里的 32 是 attention backend 真实使用的 kernel page token 数。可 vLLM 后续给 LMCache 的 block id 仍然是 544-token logical block 的 id。一个 logical block 其实占 17 个连续 kernel pages:
logical block 0 = kernel pages 0..16
logical block 1 = kernel pages 17..33
如果 LMCache 直接把这个 tensor 当成 block size 32,就会把 block id 坐标系理解错。解决方式是把 17 个 kernel pages re-view 成 1 个 logical page:
[num_kernel_pages, 2, 32, H, C]
        |
        | view, no copy
        v
[num_logical_blocks, 2, 544, 1, C']
逐维拆开看:
| 原始维度 | 新维度 | 为什么这样变 |
|---|---|---|
num_kernel_pages |
num_logical_blocks = num_kernel_pages / 17 |
原始第一维数的是 32-token kernel page。vLLM block id 数的是 544-token logical block。因为 544 / 32 = 17,所以 17 个连续 kernel pages 合成 1 个 logical block。这里要求 num_kernel_pages 必须能被 17 整除。 |
2 |
2 |
这一维保留下来,是为了让 LMCache 后面的通用 KV transfer 仍看到一个 rank-5、kv_size = 2 的形状。注意 re-view 后它不再可靠表示“整个 logical block 的纯 K plane / 纯 V plane”。 |
32 |
544 |
原始 32 是 kernel page 里的 token slot 数;新 544 是 vLLM scheduler 认的 logical block size。LMCache 后续按 block id 搬运时,需要看到的是 544-token block 坐标,而不是 32-token kernel page 坐标。 |
H |
1 |
原始 H 是真实 attention head 数。但这个 view 的目标不是让 LMCache 理解每个 head 的语义,而是让一整个 logical page 的 bytes 能被当成一个可搬运 payload。代码里使用 1 个 synthetic head。 |
C |
C' |
原始 C 是每个 head 的宽度。因为 H 被折叠成 1,原来分散在 H * C 里的内容会被塞进新的 trailing width。简单情况下 C' = H * C;真实代码会用 spec.page_size_bytes / element_size / (2 * 544 * 1) 算出来,确保一页元素数正好对上。 |
所以这个 view 不是在重新解释 attention 的数学语义,而是在建立一个“block id 到 byte range”的地址视图。它要求 raw tensor 是 contiguous;它不会搬动任何 byte,只是把同一段 storage 用新的 shape 标出来。只要 STORE 和 RETRIEVE 使用同一套视图,bytes 就能正确 round-trip。但这也意味着,re-view 之后不能再把 kv_caches[:, 0] 当作纯 K tensor 做内容感知处理,因为 K/V 可能已经按 kernel-page 粒度交错在这个 opaque payload 里。
MLA cache 通常不是标准的 K/V 两个 plane。它更像 key-only 或 latent state cache,一行 state 可以服务多个逻辑 token。PR #5042 重点补的是 GLM / Kimi 这类 MLA cache:worker kernel 用更小的 page 存,LMCache 要把多个 kernel pages 合成一个 logical block view。
比如 Kimi K3 这类 rank-3 MLA cache:
raw worker tensor:
[N * 12, 64, 576]

meaning:
每 64 行 state 是一个 kernel page
12 个 kernel pages 拼成 vLLM 调度侧的一个 logical block

edited view:
[N, 768, 576]
这里 rank-3 的意思只是 tensor 有 3 个维度:[num_blocks, states, hidden]。普通 K/V attention 常见是 rank-5:[num_blocks, 2, block_size, num_heads, head_size]。
PR 还支持 rank-4 MLA:
[NB, 1, states, C]   # head slot 在 states 前面,类似 HND
[NB, states, 1, C]   # head slot 在 states 后面,类似 NHD
这个 1 是一个单 head slot。MLA 在 LMCache transfer 层常被看作 kv_size = 1、num_heads = 1 的 key-only 格式;那个 head 维度只是为了适配通用 kernel 描述,不代表普通 MHA 的多头 K/V。
Mamba / Gated DeltaNet 这类 recurrent 层保存的不是逐 token K/V,而是递归状态快照。旧路径里,一个 Mamba layer 可能注册成:
[conv_state, ssm_state]两个 tensor shape 和 dtype 都可能不同,但它们其实共享一个 padded page:
conv bytes | ssm bytes | paddingLMCache 的 transfer path 更擅长处理“每个 block 一个 page”的 tensor,所以注册前会把 Mamba page re-view 成类似 attention 的 opaque page:
[num_blocks, 2, block_size, 1, head_size]这里的 2 也不是真正的 K/V,只是把一整页 bytes 切成 transfer kernel 能走的形状。PR #5042 还补了 unified Mamba view 对 BLNHC / BLHNC 的支持:blocks-first layout 和原来的 layers-first layout 在这条 view 里可以归约成同样的 inner shape 选择。
动态图 3
Mamba / linear attention 保存的是 recurrent state snapshot,不是每个 token 一份 K/V。这里先把 conv_state 和 ssm_state 当成两段不同形状的 bytes。
[num_blocks, page_bytes]
[num_blocks, 2, block_size, 1, head_size]
recurrent_state = true
sw_size_tokens = block_size
先把名字说清楚:create_engine_group_info_from_engine 不是这个 PR 当前代码里的函数名,更像讨论时容易说出口的“泛称”或旧式单数叫法。当前代码里的实际入口是:
create_engine_group_infos_from_vllm(...)它在 lmcache/integration/vllm/kv_cache_groups.py 里,被 LMCacheConnectorV1Impl.register_kv_caches 调用。函数名里有三个值得注意的词:
| 名字片段 | 含义 |
|---|---|
infos |
返回的不是一个 info,而是一组 info:list[EngineGroupInfo] |
from_vllm |
这里读的是 vLLM 的 KVCacheConfig / KVCacheGroupSpec,不是 engine-neutral 的抽象对象 |
EngineGroupInfo |
单个元素描述的是 LMCache 协议里的一个 transfer/kernel group,以及它来自哪个 serving-engine block-id group |
为什么一定是 list[EngineGroupInfo]?不能只用“一 vLLM group 可能拆成多个 LMCache kernel group”这一句话概括。它只是最常见的原因之一。当前代码里,最后返回多少个 info,取决于 group_layers_by_identity(...) 产出的多少个 transfer identity;而这个 identity 里包含:
(kv_size, num_heads, head_size, slots_per_block,
 engine_group_idx, dtype, engine_kv_format)
所以 list[EngineGroupInfo] 可能因为下面这些情况变长、变短,或者保持为空:
| 情况 | 会发生什么 | 为什么 |
|---|---|---|
| vLLM 本来就有多个 engine group | 通常会至少产生多个 EngineGroupInfo |
不同 vLLM engine group 是不同 block-id address space;即使 tensor shape 一样,也不能混用 block ids |
| 同一个 vLLM engine group 内有不同物理 layout | 一个 engine_group_id 会拆成多个 EngineGroupInfo |
比如 main KV 是 rank-5 K/V,indexer 是 rank-3 key-only;它们共享同一份 block id list,但 copy kernel 形状不同 |
| 同一个 engine group 内 shape / dtype / head 配置不同 | 继续按 identity 拆分 | kv_size、num_heads、head_size、slots_per_block、dtype 任一不同,都可能需要不同 kernel descriptor |
| 没有 vLLM group metadata 的非 hybrid 情况 | 也可能返回多个 info | per_layer_engine_group_idx 为 None 时,所有 layer 都被当作 engine group 0;但如果真实 tensor layout 不同,仍会按 physical identity 拆开 |
| CacheBlend 注册 connector 私有 aux pool | 会追加 synthetic engine group | aux pool 不是 vLLM 原生 group,但也要独立 format discovery、注册和传输,所以会生成额外 group id,并带 extra_object_group_tag |
scratch / prefix_cacheable = False group |
不会产生 EngineGroupInfo |
这些是请求内临时 ring buffer,不属于可复用 prefix KV;代码用 tokens_per_block = 0 表示排除 |
| cross-layer KV sharing / alias layer | 相关 layer 会被排除 | 如果某些 layer 的 KV 实际由 owner layer 持有,重复注册会导致重复搬运或 block-size 计算错误 |
还有一些字段会影响 EngineGroupInfo 的内容,但不一定独立制造新的 info。比如 DCP 会改变 attention 的 tokens_per_block;sliding-window 会写入 sw_size_tokens;Mamba / linear attention 的 state snapshot 会写入 recurrent_state。它们会继续影响服务端 object group、window 语义和 block 数量计算,但“是否多出一个 info”仍要看 engine group id 和 physical transfer identity 是否分开。
它要解决的问题是:vLLM 的 group 和 LMCache 的 transfer group 不是同一个概念。
vLLM 的 engine group 关心的是调度语义:
这些 layer 共享同一种 cache spec。
这些 layer 的 block id 属于同一个 paged-block address space。
LMCache 的 kernel group 关心的是搬运语义:
这些 layer 能不能用同一个 copy kernel?
它们的 kv_size、num_heads、head_size、slots_per_block、dtype、engine_kv_format 是否一样?
它们的 block id 坐标系是否一样?
所以 create_engine_group_infos_from_vllm 的职责不是“照抄 vLLM groups”,而是把两套信息合成一个服务端也能复现的协议。
kv_caches 是有顺序的 dict。函数先把它变成 list,并记录每个 layer name 对应第几个 tensor:
per_layer_discoverable_kv_caches = list(kv_caches.values())
layer_to_idx = {name: idx for idx, name in enumerate(kv_caches.keys())}
后面所有 group metadata 都会从 layer name 转成 layer index。比如注册列表里第 0、2、4 个 tensor 属于同一个 vLLM group,服务端收到 EngineGroupInfo(layer_indices=(0, 2, 4)) 时,不需要认识 vLLM 的 layer name,只要按注册 tensor 列表的 index 工作。
动态图 4
先把有序 dict 摊平成 registered tensor list;从这一步之后,跨进程协议尽量只讲 index,不再要求 server 理解 vLLM layer name。
model.layers.0.self_attn.kv_cacherank-5 K/Vmodel.layers.1.qsa_ringprefix_cacheable = falsemodel.layers.2.self_attn.kv_cacherank-5 K/Vmodel.layers.3.mla_indexerrank-3 uint8model.layers.4.self_attn.kv_cacherank-5 K/V[layer.0, layer.2, layer.4]
[layer.1] → tokens_per_block = 0
[layer.3] → rank-3 / uint8
engine_group_id = 0
layer_indices = (0, 2, 4)
layer 1 stays EXCLUDED
engine_group_id = 2
layer_indices = (3,)
(0, 2, 4) 在这里就是这个小例子的结果:它来自 registered tensor list 的位置,不要求模型真实只注册偶数层。format discovery 是 LMCache 根据真实 tensor shape / stride 判断 KV 格式的过程,比如:
rank-5 [NB, 2, BS, NH, HS]       -> 普通 K/V attention
rank-3 [NB, BS, HS]              -> MLA key-only
rank-4 [NB, BS, 1, HS]           -> blocks-first / single-head style view
PR #5042 在这里加了一个关键逻辑:scratch group 不参与 format discovery。
scratch group 是 vLLM 标记 prefix_cacheable = False 的 group。它不是 token prefix 的可复用 KV,而是请求生命周期内的临时 ring buffer。既然后续不会 store/retrieve 它,就不应该因为它的 layout 奇怪而让注册失败。
所以代码会这样构造 layer_index_groups:
layer_index_groups = [
    [layer_to_idx[name] for name in group.layer_names]
    for group in vllm_groups
    if not is_scratch_spec(group.kv_cache_spec)
]
is_scratch_spec 的判断很朴素:如果 spec 有 prefix_cacheable 且为 false,就认为它不属于 prefix cacheable KV。老版本 vLLM 没这个字段时,默认按 token-paged spec 处理。
这里调用的是:
normalize_and_discover_per_layer_formats(
    per_layer_discoverable_kv_caches,
    layer_index_groups,
    EngineType.VLLM,
    layout_hints,
)
它返回两样东西:
normalized_kv_caches
engine_kv_formats
normalized_kv_caches 是经过 contiguous-view recovery / detector 处理后的 tensor view;engine_kv_formats 是每个 layer 对应的 LMCache native format。
为什么要 per-layer format?因为一个 vLLM group 里可能同时出现普通 K/V cache 和 MLA indexer cache。它们在调度侧可能属于同一个 UniformTypeKVCacheSpecs group,但物理 tensor 格式完全不同:
main attention cache:
[NB, 2, BS, NH, HS]       # rank-5, kv_size=2

MLA indexer cache:
[NB, states, C]           # rank-3, kv_size=1
如果只给整个模型或整个 vLLM group 判一个 format,就会把 indexer 当成普通 K/V,或者把普通 K/V 当成 MLA。PR 相关测试里专门覆盖了这种“一组里混 rank-5 K/V 和 rank-3 key-only MLA index cache”的情况。
接下来函数初始化:
per_layer_group_idx = [EXCLUDED_ENGINE_GROUP] * num_layers这一步特别有意思。默认不是“所有 layer 都进 group 0”,而是“除非 vLLM 明确说这个 layer 属于某个可缓存 group,否则先排除”。
为什么?因为有些模型会做 cross-layer KV sharing。比如某些多 backbone 或共享 KV 的结构里,一个 layer 的 KV 实际 alias 到另一个 owner layer 的 KV tensor;vLLM 的 kv_cache_groups 只列出 cache-owning layer。被共享的 layer 不应该自己再形成一个 LMCache group,否则会重复搬运,甚至因为 block size 不一致导致 block id 数量算错。
对于每个 vLLM group,函数会算:
group_tokens_per_block[engine_group_id] = get_tokens_per_block(
    group.kv_cache_spec, dcp_size
)
这里 tokens_per_block 是非常关键的逻辑量:一个 vLLM block id 覆盖多少个逻辑 token。
普通 attention 下:
tokens_per_block = spec.block_sizeDCP 场景下,attention group 的 scheduler 坐标会按 dcp_size 放大:
tokens_per_block = spec.block_size * dcp_sizeMamba recurrent state 是复制式状态,不按 DCP shard 这一维放大,所以保持 spec.block_size。
scratch group 则是:
tokens_per_block = 00 在这里是一个标记:这个 group 不覆盖可缓存 prefix token。函数遇到 0 就不会把它的 layer 填进 per_layer_group_idx,最后它不会形成任何 EngineGroupInfo。
同样的 layer index 映射还会被用于两个辅助属性:
per_layer_sw_size
per_layer_recurrent
sliding-window attention 只保留一个窗口范围内的历史 KV。LMCache 存取 chunk 时,要知道这个 group 是否只能跨 chunk 看有限窗口。Mamba / linear attention 的 align/all cache mode 保存的是 recurrent state snapshot,恢复语义也像一个一 block window:命中时真正有用的是最后一个匹配 block 的状态。
所以 EngineGroupInfo 里会带:
sw_size_tokens
recurrent_state
这会继续影响服务端 object group 和 attention window descriptor。
CacheBlend 可能会注册 connector 私有的 aux page pool,名字形如:
cb.aux_pool.<tokens_per_block>[.<label>]它不是 vLLM 原生 group,但也需要参与注册、format discovery 和后续存取。因此函数会把它放到 vLLM groups 之后,生成 synthetic engine group,并用 extra_object_group_tag 标记。
这个细节说明 EngineGroupInfo 不是“vLLM 原始 group 的镜像”。它是 LMCache 的协议视图:既能承载 vLLM group,也能承载 connector 自己需要的额外 page pool。
最后一步调用:
group_layers_by_identity(
    normalized_kv_caches,
    engine_kv_formats,
    per_layer_group_idx,
)
它的 identity 是:
(kv_size, num_heads, head_size, slots_per_block,
 engine_group_idx, dtype, engine_kv_format)
每个 identity 会形成一个 LMCache kernel group。这里每个字段都有原因:
| 字段 | 为什么影响分组 |
|---|---|
kv_size |
普通 K/V 是 2,MLA key-only 常是 1,kernel 处理方式不同 |
num_heads |
head 数影响每个 block 的布局和 copy shape |
head_size |
每个 head/state 行宽不同,copy shape 不同 |
slots_per_block |
物理 page 里有多少 slot,不一定等于逻辑 token 数 |
engine_group_idx |
block id 只在同一个 vLLM engine group 内有意义 |
dtype |
bf16/fp16/uint8 的 element size 和 kernel specialization 不同 |
engine_kv_format |
同一 group 内 rank-5 K/V 与 rank-3 MLA 不能合并 |
最终函数 emit:
EngineGroupInfo(
    engine_group_id=identity.engine_group_idx,
    layer_indices=tuple(indices),
    tokens_per_block=...,
    sw_size_tokens=...,
    extra_object_group_tag=...,
    recurrent_state=...,
)
这份 list[EngineGroupInfo] 就是客户端和服务端共同遵守的分组协议。
最简单的情况是所有 layer 都是 full attention,所有 layer 的 KV tensor shape 一样:
kv_cache_config.kv_cache_groups:
  group 0:
    layer_names = [layer.0, layer.1, ..., layer.N]
    block_size = 16

kv_caches:
  layer.0 -> [NB, 2, 16, NH, HS]
  layer.1 -> [NB, 2, 16, NH, HS]
  ...
这时 create_engine_group_infos_from_vllm 基本会产生一个 info:
EngineGroupInfo(
  engine_group_id = 0,
  layer_indices = (0, 1, ..., N),
  tokens_per_block = 16,
  sw_size_tokens = -1,
  recurrent_state = false
)
服务端后续也会建一个 kernel group:所有 layer 用同一个 shape descriptor,一个 STORE / RETRIEVE 请求里对这个 group launch 一类 copy kernel。
这里是最朴素的“一 vLLM block 一 tensor page”:
block id 10 -> tensor page 10 -> 16 token slotstokens_per_block == slots_per_block,没有压缩,也没有 re-view。
MLA 的 KV cache 不一定有普通 attention 的 K/V 两个 plane。常见 key-only MLA 可以是:
[num_blocks, block_size, hidden]也就是 rank-3。LMCache 会把它理解成:
kv_size = 1
num_heads = 1
head_size = hidden
slots_per_block = block_size
如果 tokens_per_block == slots_per_block,它只是格式不同,不是压缩。
DeepSeek-V3.2 相关路径容易让人误会,因为它也有 MLA、也有压缩感很强的名字。但这里要区分两种“压缩”:
tokens_per_block > slots_per_block;PR 文档里提到 DeepSeek-V3.2 的 fp8_ds_mla 更接近后者:它压的是每个 slot 的表示 bytes,而不是把多个 token 塞进一个 slot。因此 spec 侧通常仍可以保持:
block_size == scheduler block size
compress_ratio == 1
对 register_kv_cache 来说,这意味着它不需要被 sub-paged view 误处理,也不应该被当成 DeepSeek-V4 式 slot compression。format detection 和 dtype/shape descriptor 会反映它的真实 bytes 布局。
带 indexer 的模型更复杂,因为同一个 vLLM group 里可能有两类物理 cache:
main MLA cache:
  [NB, states, 512], bf16

indexer cache:
  [NB, states, 132], uint8
它们可能共享一个 UniformTypeKVCacheSpecs group,因为调度侧希望它们使用同一个 engine block-id address space。但 LMCache transfer 不能把它们合成一个 kernel group:宽度、dtype、甚至每个 block 的 states 数都不同。
所以 normalize_and_discover_per_layer_formats 会在 group 内按 tensor shape 再分开 detection,group_layers_by_identity 又会因为 head_size / dtype / engine_kv_format 不同,把它们拆成不同 EngineGroupInfo:
info 0:
  engine_group_id = 0
  layers = main MLA layers

info 1:
  engine_group_id = 0
  layers = indexer layers
注意两个 info 可以共享同一个 engine_group_id。这表示它们读取同一份 vLLM block id list,只是 transfer kernel 分开跑。
DeepSeek-V4-Flash 这类模型会把问题再推进一步:不同 group 可以有不同 tokens_per_block,有的 group 还有 slot compression。
比如概念上可能出现:
group 0: full attention, tokens_per_block = 256, slots_per_block = 256
group 1: sliding-window, tokens_per_block = 64, slots_per_block = 64
group 2: compressed MLA, tokens_per_block = 8, slots_per_block = 2
group 3: indexer, tokens_per_block = 4, slots_per_block = 1
LMCache 不能再假设“整个模型只有一个 block size”。它必须对每个 group 分开计算:
compress_ratio = tokens_per_block / slots_per_block
blocks_per_chunk = lmcache_chunk_size / tokens_per_block
这也是为什么 EngineGroupInfo 要带 tokens_per_block,而服务端 KVLayerGroupsManager 要从真实 tensor 里重新检测 slots_per_block。
至于多 backbone 或 cross-layer KV sharing,核心问题不是压缩,而是某些 layer 没有独立 KV owner。vLLM 可能只把 cache-owning layer 放进 kv_cache_groups,其他 layer alias 到 owner 的 KV cache。LMCache 的默认策略是:没被 vLLM group 明确覆盖的 layer 标成 EXCLUDED_ENGINE_GROUP,不让它形成自己的 transfer group。因为 owner layer 的 KV 搬一次就够了。
PR #5042 的核心新增点之一,是把 prefix_cacheable = False 的 group 从 prefix KV 注册路径里排除。
Qwen3.8-Flash-Next 这类模型会有 QSA compressor ring,GLM-5.3-Flash 也有 kpool tail 一类结构。这些 buffer 的共同点是:
它们是请求内临时状态;
通常按 pos % capacity 覆盖;
vLLM 自己也不把它们作为 prefix cache 恢复;
它们不表示一个可跨请求复用的 token prefix。
如果 LMCache 把它们当成普通 group,就会发生两个问题。
第一,调度侧 token span 会被拉低。比如普通 group 一个 block 覆盖 1600 token,scratch ring capacity 只有 8。如果统一取最小值,LMCache 会以为可存前缀只能按 8 token 对齐,真实 store chunk 逻辑就乱了。
第二,scratch tensor 的 layout 可能根本不是 LMCache transfer kernel 支持的 layout。既然它不需要 transfer,就不该让 format discovery 在这里失败。
PR 的处理是端到端排除:
is_scratch_spec(spec) -> prefix_cacheable == False
get_tokens_per_block(spec) -> 0
format discovery -> skip this group
per_layer_group_idx -> remains EXCLUDED_ENGINE_GROUP
EngineGroupInfo -> no entry emitted
slice_block_ids_per_group -> tokens_per_block 0 yields empty block list
所以更准确的术语应该是 non-prefix-cacheable KV cache group。scratch ring 是当前例子,不宜把所有情况都叫 scratch layer,因为这里排除的是 group 的可缓存语义,不是某一个 Transformer layer 的语义。
PR 还把 _SubpagedMLAAttentionViewEdit 扩展到 rank-4,并且让它用 spec.num_states 或老版本的 block_size / compress_ratio 来决定 logical states 数。
这解决的是 GLM-5.3-Flash 这类情况:
block_size = 1152

sparse MLA:
  kernel rows = 64
  logical states = 1152
  ratio = 18

kpool indexer:
  tokens_per_state = 4
  logical states = 1152 / 4 = 288
  kernel rows = 32
  ratio = 9
它们可能在同一个 UniformTypeKVCacheSpecs group 里,但每个 layer 的 leaf spec 不同。PR 因此把 edit 改成按 per-layer spec 匹配,而不是拿整个 group 的 outer spec 一刀切。
vLLM 新 layout 里可能出现 blocks-first 的 BLNHC / BLHNC。对 Mamba unified state 来说,输入更像:
[num_blocks, 1, 1, row]其中 row 是这一层 recurrent state 的一整行,stride(0) 是每个 block 跨过的 padded page 大小。LMCache 要把它 view 成:
NHD / BLNHC -> [num_blocks, block_size, 1, head_size]
HND / BLHNC -> [num_blocks, 1, block_size, head_size]
PR 的关键判断是:对这个 Mamba view 来说,blocks-first 和 layers-first 在 inner dims 的选择上可以归为同一类;BLNHC 像 NHD,BLHNC 像 HND。
还有一个看上去很小但很关键的修改在 attempt_permute_to_contiguous_view:
perm = sorted(
    range(kv_caches.ndim),
    key=lambda i: (strides[i], shape[i] != 1),
    reverse=True,
)
这个函数会按 stride 从大到小重排维度,试图把一个被 permute 过的 tensor 恢复成物理连续布局。问题是 size-1 维度经常和相邻维度 stride 一样。例如一个只有 1 个 KV head 的 BLNHC view 可能有:
shape  = [NB, 1, BS, HS]
stride = [block_step, HS, HS, 1]
head 维度和 token 维度 stride 都是 HS。如果排序不稳定地把 size-1 head 放到 token 前面,LMCache 可能得到 [NB, 1, BS, HS];但物理上更合理的连续 view 是 [NB, BS, 1, HS]。
shape[i] != 1 这个 tie-break 的意思是:stride 相同的时候,非 size-1 维度排在更外侧,size-1 维度排在更内侧。因为 size-1 维度本身不展开真实地址范围,把它放内侧更符合从 stride 推导连续 shape 的结果。
回到主流程。生成 engine_group_infos 之后,LMCacheMPConnector 会调用 worker_adapter.register_kv_caches。
这一层做三件事。
第一,先验证 LMCache chunk size 和每个 group 的 tokens_per_block 是否对齐:
for info in engine_group_infos:
    if info.tokens_per_block > 0 and chunk_size % info.tokens_per_block:
        raise ValueError(...)
LMCache 存储对象通常按 chunk 组织。如果一个 group 的 block 覆盖 64 token,而 chunk size 是 256,那么每个 chunk 正好 4 个 block。如果一个 group 的 block 覆盖 544 token,那么默认 chunk size 256 就不成立,因为一个 chunk 连一个完整 logical block 都放不下。必须显式改成 544、1088 或其它 544 的倍数。如果不能整除,chunk 边界会落在某个 vLLM block 中间,STORE / RETRIEVE 很难保持一致。
第二,把 kv_caches、engine_group_infos、layout_hints 保存下来。这不是为了好看,而是为了 heartbeat recovery。server 重启或恢复时,worker 可以用同一份信息重新注册。
第三,创建 transfer context 并发送注册请求:
transfer_ctx = create_transfer_context(kv_caches, mode=self._mp_transfer_mode)
transfer_ctx.register(...)
在 LMCache driven 模式下,选出来的是 LMCacheDrivenTransferContext。它会检查 event IPC 支持,然后把 KV tensor 包成 IPC wrapper,通过 request client 发送 REGISTER_KV_CACHE。
这一刻之后,worker 侧的注册动作才算完成:它等待 server 返回 response。如果超时,用户看到的是“LMCache server did not respond to register_kv_caches”这类错误。
服务端 handler 在 LMCacheDrivenTransferModule.register_kv_cache。请求是同步 handler,所以同一个 instance_id 的注册不会并发乱插。
服务端第一步是 liveness 去重:
existing = self._cache_contexts.get(instance_id)
if existing is not None:
    existing.last_seen = now
    return
如果 worker 已经注册过,比如 heartbeat recovery 的边界上重复注册,server 不会重新 import 一遍 KV handle,而是刷新 last_seen。这样可以避免刚恢复的 worker 被 stale reaper 误清掉。
第二步是创建 cache context:
cache_context = create_cache_context(
    kv_caches,
    chunk_size,
    layout_hints=layout_hints or None,
    engine_group_infos=engine_group_infos,
    engine_type=engine_type,
    separate_object_groups=...,
    full_sw_kv=...,
)
这里的 kv_caches 已经是服务端收到的 DeviceIPCWrapper 列表。create_cache_context 会根据 wrapper 指向的 device type 选择对应 backend。GPU 上会走 GPUCacheContext。
GPUCacheContext 初始化里有几个细节:
unwrap_kv_cache_tensors(kv_caches),把 wrapper import 成服务端进程可见的 tensor view。normalize_and_discover_per_layer_formats。服务端不会盲信客户端已经 detect 过,而是基于 import 后的真实 tensor view 和 engine_group_layer_indices(engine_group_infos) 复现格式检测。KVLayerGroupsManager。这里最关键的是第 4 步:KVLayerGroupsManager 是服务端运行时真正使用的分组对象。
客户端发来的 EngineGroupInfo 仍然是协议层 metadata。服务端要把它变成可执行的 kernel group。
KVLayerGroupsManager 会先根据 EngineGroupInfo 得到每个 registered layer 属于哪个 engine group:
layer 0 -> engine group 0
layer 1 -> EXCLUDED_ENGINE_GROUP
layer 2 -> engine group 2
然后服务端用同一个 group_layers_by_identity 重新分组。客户端和服务端使用同一个 grouping primitive,这是一个很重要的防错设计:只要两边看到的 tensor shape/format 一致,group 顺序就能一致。
服务端每个 kernel group 会产生一个 KernelGroupInfo,里面包括:
| 字段 | 来源 |
|---|---|
layer_indices |
EngineGroupInfo 和 identity 分组 |
shape_desc |
真实 tensor format + shape + stride 推导 |
dtype |
真实 tensor dtype |
tokens_per_block |
客户端从 vLLM spec 带过来的逻辑 token 数 |
slots_per_block |
服务端从真实 tensor shape_desc.bs 检测出来的物理 slot 数 |
engine_group_idx |
这组 layer 使用哪份 vLLM block id list |
sw_size_tokens |
sliding-window 或 Mamba one-block window |
recurrent_state |
是否 Mamba / linear recurrent state |
这里的 tokens_per_block 和 slots_per_block 必须分开看。
tokens_per_block:
  一个 vLLM block id 在调度语义上覆盖多少 token。

slots_per_block:
  一个物理 tensor page 里有多少 state/token slot。
普通 attention:
tokens_per_block = 16
slots_per_block  = 16
compress_ratio   = 1
compressed MLA / indexer:
tokens_per_block = 1152
slots_per_block  = 288
compress_ratio   = 4
LMCache 不需要在协议里单独存 compress_ratio。它在需要时用:
tokens_per_block / slots_per_block算出来。
服务端还会校验三类对齐:
tokens_per_block 必须是 slots_per_block 的整数倍;tokens_per_block 的整数倍;tokens_per_block 对齐。校验失败就注册失败。这样比后续 STORE 一半才发现坐标错要好得多。
LMCacheDrivenTransferModule.register_kv_cache 创建完 cache context 后,还会做 layout descriptor 注册:
layout_desc = get_layout_desc(cache_context, chunk_size, object_group_id=0)
group_layout_descs = {
    gid: get_layout_desc(cache_context, chunk_size, object_group_id=gid)
    for gid in range(num_object_groups)
}
attn_desc = kv_groups_manager.get_attn_desc()
self._ctx.layout_desc_registry.register(
    model_name,
    world_size,
    layout_desc,
    attn_desc,
    group_layout_descs=group_layout_descs,
)
这一步是为了让 LMCache 的存储层和分布式路径知道“这个模型、这个 world size 的缓存对象长什么样”。
为什么要按 object group 注册多份 layout?因为开启 separate_object_groups 时,full attention、sliding-window、recurrent state、CacheBlend aux pool 可能不能放在同一个对象组里。它们的生命周期、window 语义、对象 key 后缀都可能不同。
attn_desc 则把 object group 的 attention window 暴露出去:
full attention       -> -1
sliding-window       -> 有限 chunk window
Mamba recurrent      -> recurrent kind + one-block window
aux pool             -> aux kind
注册完 layout desc 后,server 才把 entry 放进 _cache_contexts:
self._cache_contexts[instance_id] = ContextEntry(
    cache_context=cache_context,
    model_name=model_name,
    world_size=world_size,
    last_seen=now,
    has_liveness_signal=False,
    event_backend=event_backend,
)
后续 STORE / RETRIEVE 就会通过 instance_id 找到这份 context。
注册之后,vLLM 侧的每次 store/load metadata 会携带 block ids。对于 hybrid model,block ids 是按 engine group 分的:
engine group 0 block ids: [10, 11]
engine group 1 block ids: [20, 21]
但 LMCache server 的 kernel groups 是 EngineGroupInfo 顺序。如果一个 engine group 被拆成两个 kernel group,那么这两个 kernel group 要复用同一份 engine block ids。
这就是 expand_engine_block_ids 的作用。假设注册时产生:
info 0: engine_group_id = 0, layers = [0, 2]
info 1: engine_group_id = 1, layers = [1, 3]
info 2: engine_group_id = 0, layers = [4]
vLLM 给:
group 0 -> [10, 11]
group 1 -> [20, 21]
LMCache 发送给 server 的会变成:
info 0 -> [10, 11]
info 1 -> [20, 21]
info 2 -> [10, 11]
动态图 5
vLLM 发来的是按 engine group 排列的 block ids;这个坐标系描述调度语义,不直接等于 server 要 launch 的 kernel group 顺序。
server 后续只要按 kernel group index 逐个跑 copy,就不会再关心 vLLM 的 layer name。
这也是为什么注册阶段一定要确定 group order。STORE / RETRIEVE 的 block id list 是按这个 order 解释的;order 错了,数据就会写到错误的 layer 或错误的 page。
可以把它浓缩成一句话:
register_kv_cache把 vLLM worker 进程里的 KV cache memory,登记成 LMCache server 可导入、可识别、可分组、可按 block id 读写的一组 runtime transfer resources。
更细一点,它完成了四层转换。
第一层,内存所有权转换:
worker-owned torch.Tensor
  -> DeviceIPCWrapper
  -> server-imported tensor view
worker 仍然拥有真实 KV buffer,但 server 可以通过 IPC mapping 访问它。
第二层,布局转换:
raw vLLM tensor shape/stride
  -> zero-copy edited view if needed
  -> EngineKVFormat / PageBufferShapeDesc
这里覆盖了 HND/NHD/BLNHC/BLHNC、sub-paged attention、sub-paged MLA、Mamba state page、contiguity recovery 等情况。
第三层,语义分组转换:
vLLM KVCacheGroupSpec
  -> EngineGroupInfo
  -> server KernelGroupInfo
vLLM group 保留 block-id address space,LMCache kernel group 保证每组能用同一个 copy kernel。
第四层,存储对象转换:
kernel groups
  -> object groups
  -> layout descriptors and attention window descriptors
这让 storage / lookup / distributed path 知道一个 chunk 在各个 group 里应该长什么样。
PR #5042 表面上包含几个不同 fix:scratch group exclusion、sub-paged MLA rank-3/rank-4、Mamba unified view layout、contiguity tie-break。它们看起来散,但都服务同一个主线:
注册阶段必须让 LMCache 看到“可缓存、可按 vLLM block id 解释、可由 transfer kernel 正确搬运”的 KV view。对 non-prefix-cacheable scratch group,正确动作是排除,因为它不是可复用 prefix KV。
对 sub-paged MLA,正确动作是 re-view,因为它是可复用 KV,只是 kernel page 粒度小于 logical block。
对 Mamba unified state,正确动作是 opaque page view,因为它不是普通 attention K/V,但可以按 recurrent state page 做 byte-level round-trip。
对 contiguity recovery,正确动作是修正 stride tie 的排序,因为 format detection 依赖 shape/stride 对物理布局的描述。
这些都发生在注册路径上。注册一旦把 group、layout、tokens/slots 关系建错,后续 STORE/RETRIEVE 再努力也只是沿着错误地图搬数据。
这就是 register_kv_cache 这块真正值得重视的原因:它不是附属初始化,而是 LMCache MP 模式把 vLLM 内部 KV 世界翻译成外部缓存系统可执行协议的地方。
如果要顺着 PR 读代码,我建议按这个顺序看:
| 问题 | 入口文件 |
|---|---|
| vLLM worker 什么时候把 KV cache 交给 LMCache | lmcache/integration/vllm/lmcache_mp_connector.py 的 register_kv_caches |
| 注册前哪些 tensor view 会被改写 | lmcache/integration/vllm/kv_cache_group_edits.py |
vLLM group 如何变成 EngineGroupInfo |
lmcache/integration/vllm/kv_cache_groups.py |
EngineGroupInfo 的协议含义和 block id helper |
lmcache/v1/multiprocess/group_view.py |
worker adapter 如何发送 REGISTER_KV_CACHE |
lmcache/integration/vllm/vllm_multi_process_adapter.py |
| LMCache driven transfer context 如何 wrap tensor | lmcache/v1/multiprocess/transfer_context/worker_transfer.py |
| 服务端如何处理注册请求 | lmcache/v1/multiprocess/modules/lmcache_driven_transfer.py |
| 服务端如何建 runtime kernel groups | lmcache/v1/kv_layer_groups.py |
| GPU context 如何 import wrapper、建 pointer 和 temp buffer | lmcache/v1/platform/cuda/cache_context.py |
| stride/shape 视图恢复为什么会影响 format detection | lmcache/v1/gpu_connector/kv_format/contiguity.py |
读的时候可以抓住一个原则:vLLM 相关字段只应该在 integration 层被理解;跨进程之后,server 消费的是 EngineGroupInfo、layout hints 和真实 tensor view。 这个边界守住了,LMCache 才能同时支持普通 attention、MLA、Mamba、scratch exclusion、multi-group 和未来更多 serving engine。